Menu
e-shop


Vzhledem k tomu, že počet senzorů v globální síti věcí (IoT) již přesáhl 75 miliard zařízení a úložiště dat se měří v zettabajtech, stává se objem dat globálním problémem pro všechna odvětví. V dodavatelských řetězcích potravinářství a zemědělství hrozí, že v důsledku rychlého technologického rozvoje, zejména v oblasti IoT a senzorů, budou uživatelé zaplavováni informacemi bez hlubšího porozumění.
V moderním zemědělství traktor, půdní senzory, drony, satelitní snímky, meteorologické stanice, nositelné senzory a inteligentní zavlažovací systémy nepřetržitě shromažďují data. Zatímco zemědělství založené na datech slibuje efektivitu, neřízené množství dat způsobují provozní a technologické problémy
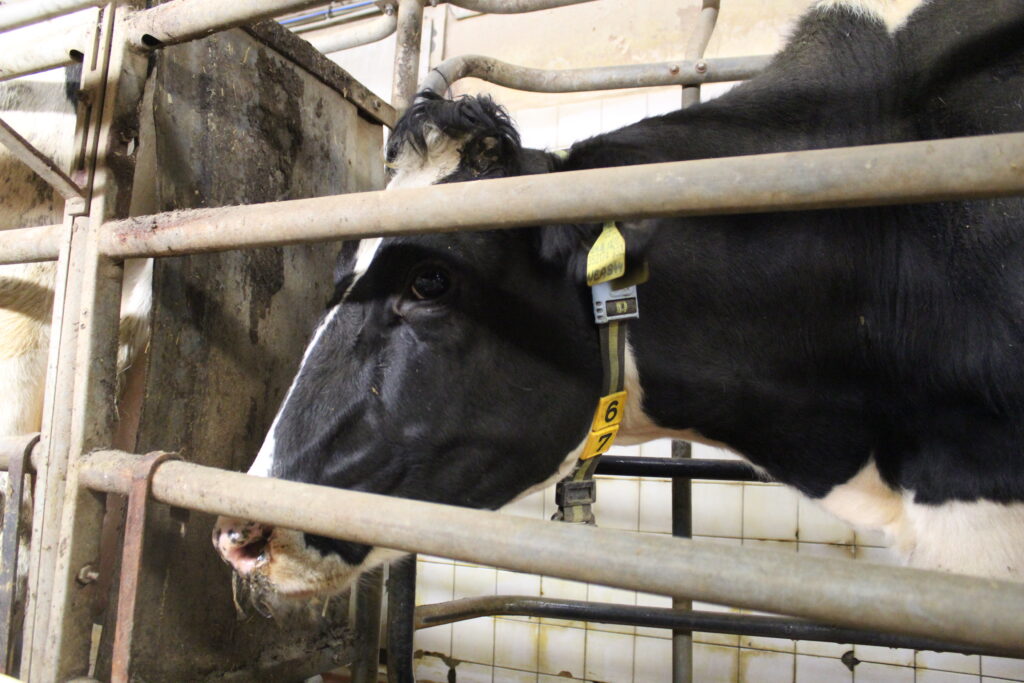
Od zemědělců až po výrobce krmiv zahlcují surová data bez syntézy provozovatele. Pěstitel, který dostává samostatná, neintegrovaná upozornění z půdních sond, meteorologických platforem a letů dronů, má potíže určit, jaká opatření jsou pro daný den prioritní. Chovatelé dojnic popisují, kolik různých upozornění poskytují obojky pro krávy, ale soustředí se pouze na jedno: detekci říje.
Každý výrobce zemědělské techniky navrhuje své vlastní izolované platformy. Nejsou v tom sami, protože do hry vstupují i společnosti zabývající se krmivy, genetikou, správou a startupy. Trpí tím farmy a všichni účastníci potravinového řetězce. Ruční převod a slaďování tabulek znamená více práce, ne méně.
Připojení na venkově představuje skutečný problém a zemědělské podniky v odlehlých oblastech často pracují s nízkým připojením k internetu. Nahrávání gigabajtů snímků ve vysokém rozlišení nebo prostorových dat ve formě obrovského množství dat na cloudové servery může přetížit místní sítě nebo zcela selhat, přičemž středně velký chov hospodářských zvířat může vygenerovat stejné množství dat jako celé město.
Ukládání terabajtů nekomprimovaných snímků nebo nepřetržitých dat ze senzorů v intervalu kratším než jedna sekunda vedlo k nadměrným výdajům na infrastrukturu jak pro agrotechnologické startupy, tak pro zemědělské podniky.
Surová data ze senzorů obsahují značné množství šumu (např. přechodné výkyvy v prostředí nebo duplicitní body GPS). Bez zpracování nebo automatického filtrování mohou být důležité signály (např. včasná detekce chorob, úniky v zavlažovacím systému) neznámé. I když někteří investoři v zemědělství považují data za cennější než samotný produkt, nebo tvrdí, že „data jsou nová ropa“, je problém topit se v datech, přestože se základní technologie sama nezaplatí. Jak tedy tento problém vyřešit?
V poslední době se nové agrotechnologické startupy při svém rozšiřování také zaměřují na budování systémů, které provádějí výpočty přímo v zařízeních, namísto toho, aby veškeré zpracování dat probíhalo mimo dané místo. Díky edge computingu (systém, který zpracovává data v blízkosti místa jejich vzniku, místo aby se vše odesílalo do vzdáleného cloudu) se díky předzpracování snížily požadavky na připojení a objem dat odesílaných do cloudu. Stručně řečeno, v boji proti přílišnému množství dat se sektor agrotechnologií odklání od pouhého dodávání surových dat směrem k edge computingu a systémům na podporu rozhodování. Neexistuje žádný zázračný lék, který by tuto formu množstvídat odvrátil; sběr, třídění, čištění a selekce dat jsou klíčem k tomu, aby se zabránilo této zbytečné zátěže, která omezuje případné úspěšné zavedení umělé inteligence v agropodnikání.
Agribusines